
· SEO, GEO & Technik
Was KI-Crawler von Ihrer Website wirklich lesen – und was JavaScript versteckt
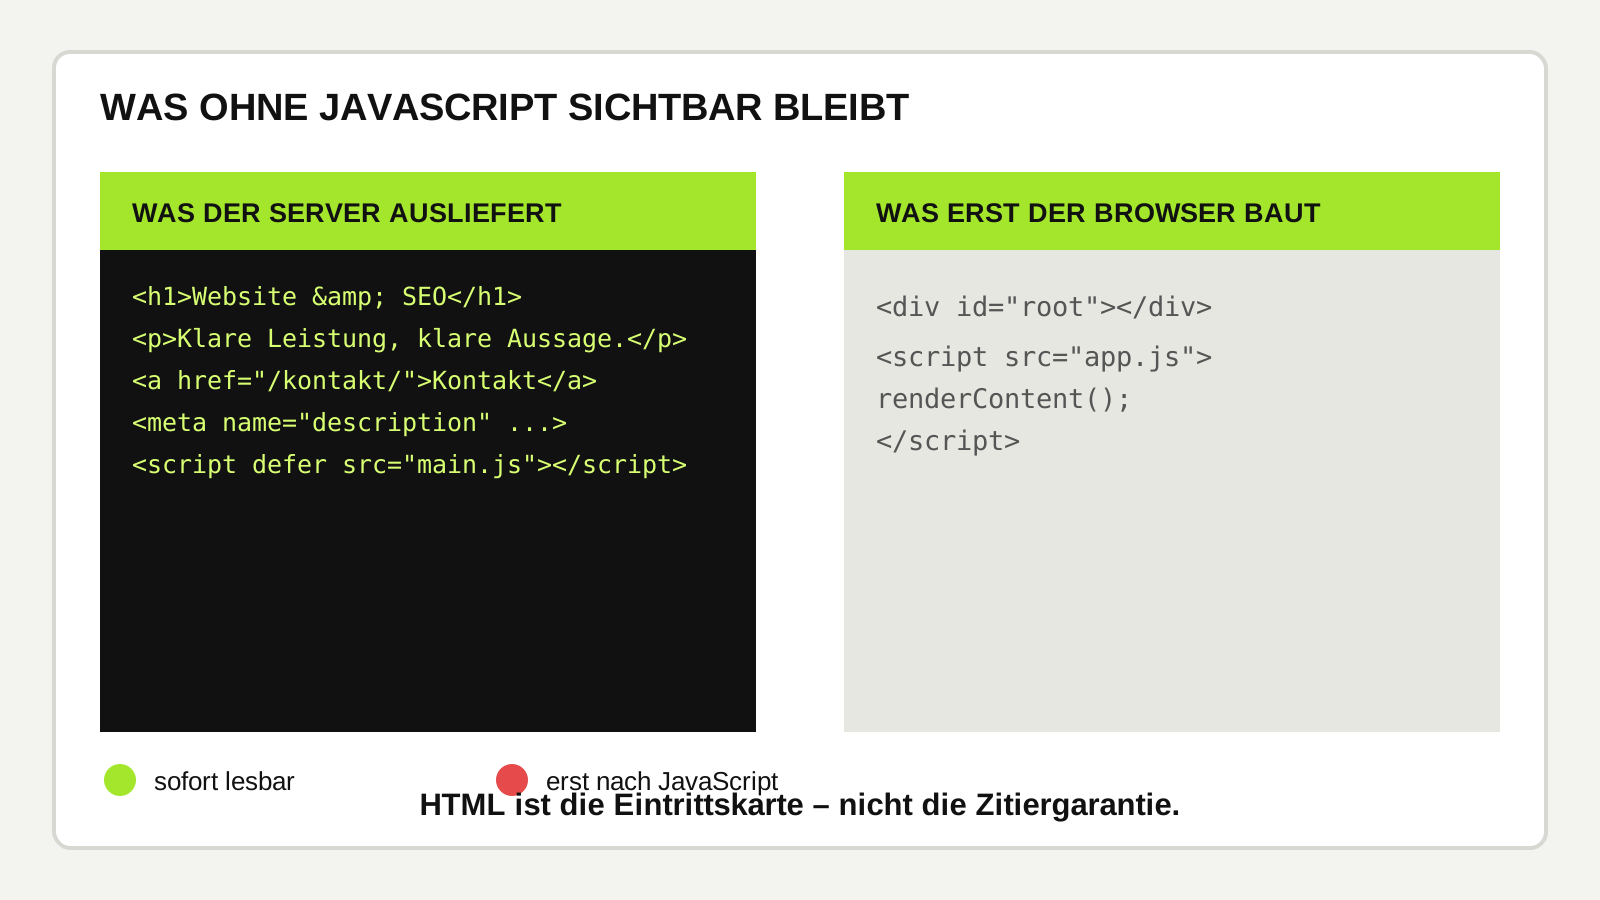
Als meine WordPress-Installation gehackt wurde, habe ich die Website in statisches HTML umgebaut. Das war zunächst keine GEO-Strategie, sondern Schadensbegrenzung: kein CMS, keine Datenbank und deutlich weniger bewegliche Teile. Heute hat diese Entscheidung einen zweiten Vorteil. Mein wichtigster Inhalt steht bereits in der Antwort des Servers und muss nicht erst von JavaScript zusammengesetzt werden.
Das ist relevant, weil die bislang größte öffentlich dokumentierte Messung, die ich dazu gefunden habe, bei mehreren spezialisierten KI-Crawlern kein JavaScript-Rendering beobachtet hat. Das bedeutet nicht, dass JavaScript schlecht ist. Es bedeutet nur: Wenn Ihre entscheidende Aussage ausschließlich nachgeladen wird, verlassen Sie sich darauf, dass der jeweilige Bot genau diesen zweiten Schritt beherrscht.
Der Drei-Minuten-Test: Steht Ihr wichtigster Satz im Quelltext?
Öffnen Sie die Seite, die gefunden werden soll, und drücken Sie Strg+U. Nicht „Element untersuchen“, nicht die fertige DOM-Ansicht, sondern wirklich den ausgelieferten Seitenquelltext. Suchen Sie dort nach dem wichtigsten Satz der Seite: dem Angebot, der Leistung, dem Produkt oder der Antwort auf die Frage, für die Sie gefunden werden wollen.
- Grün: Der Satz, die Überschrift und die wesentlichen Links stehen im HTML. JavaScript darf die Seite trotzdem schöner und interaktiver machen.
- Gelb: Ein Teil steht im Quelltext, wichtige Details erscheinen aber erst nach dem Nachladen. Diese Teile sind für manche Crawler unsicher erreichbar.
- Rot: Im Quelltext steht nur ein App-Container, ein Spinner oder eine leere Struktur. Ohne JavaScript gibt es für den Crawler kaum Inhalt.
Der gleiche Test im Terminal:
curl -sS -L -A "OAI-SearchBot" https://www.example.de/Das simuliert weder die IP-Adresse noch die komplette Verarbeitung eines echten OpenAI-Bots. Es zeigt Ihnen aber ehrlich, welche HTML-Antwort Ihr Server ohne Browser-Rendering ausliefert. Suchen Sie darin nach Ihrem wichtigsten Inhalt und prüfen Sie zusätzlich Statuscode, Weiterleitungen, 403, 404 und 429.
Wenn Sie nur in den DevTools auf „Elements“ schauen, sehen Sie häufig bereits das fertige Ergebnis nach JavaScript. Das kann beruhigend aussehen und trotzdem am ausgelieferten HTML vorbeigehen. Genau diese Unterscheidung ist der Kern des Themas.
Was die Messung wirklich belegt
Vercel und MERJ haben im Dezember 2024 Zugriffe auf nextjs.org, im Vercel-Netzwerk und auf zwei Jobportalen ausgewertet. In einem Monat registrierten sie 569 Millionen Abrufe von GPTBot und 370 Millionen von Claude. Entscheidend ist für mich aber ein anderer Befund: OAI-SearchBot, ChatGPT-User, GPTBot, ClaudeBot und PerplexityBot führten in dieser Messung kein JavaScript aus. ChatGPT- und Claude-Crawler luden teilweise Skriptdateien, renderten daraus aber nicht die fertige Browseransicht.
Das ist eine große reale Stichprobe, aber eben eine Messung aus 2024 und keine ewige Zusage der Anbieter. Genau deshalb schreibe ich nicht pauschal „KI-Crawler können kein JavaScript“. Ich schreibe: Mehrere damals wichtige spezialisierte Crawler konnten es in dieser Auswertung nicht, während Googlebot und Applebot anders arbeiteten. Wer eine Website dauerhaft nur für einen aktuellen Bot-Trick baut, baut am Thema vorbei.
Auch eine statische Seite wird natürlich nicht automatisch zitiert. Sie muss erreichbar, verständlich, aktuell und inhaltlich belastbar sein. HTML ist die Eintrittskarte, nicht die Eintrittsgarantie. Für die inhaltliche Seite habe ich deshalb im Beitrag SEO und GEO als Zusammenspiel beschrieben, warum saubere Überschriften, Quellen, Autorenschaft und klare Aussagen zusammengehören.
Google ist nicht dasselbe wie ein KI-Crawler
Google arbeitet laut eigener JavaScript-Dokumentation in drei Phasen: crawlen, rendern, indexieren. Seiten mit Status 200 gehen grundsätzlich in eine Render-Warteschlange und werden später mit Chromium verarbeitet. Das funktioniert anders als bei den spezialisierten KI-Crawlern aus der Vercel-Auswertung – aber nicht zwangsläufig sofort. Google weist darauf hin, dass eine Seite Sekunden oder länger auf das Rendering warten kann und blockierte Ressourcen nicht ausgeführt werden.
Für Übersichten mit KI und den KI-Modus verlangt Google nach eigener Aussage keine besondere GEO-Datei und kein spezielles Schema-Markup. Die Seite muss indexierbar und für ein Such-Snippet geeignet sein; klassische SEO-Grundlagen bleiben relevant. Das passt zu meiner Haltung: robots.txt, Sitemap, sichtbare Texte, interne Links und passende strukturierte Daten bilden die Basis. Meine llms.txt ergänzt diese Maßnahmen für andere Systeme, ersetzt aber keine davon.
Serverseitiges Rendering, statische Vorab-Ausgabe oder ein HTML-Fallback bleiben deshalb sinnvoll. Sie bringen den entscheidenden Inhalt in die erste Antwort. JavaScript darf weiterhin filtern, animieren und Komfort liefern. Es sollte nur nicht der einzige Ort sein, an dem die Aussage überhaupt existiert.
Was Logfiles beweisen können – und was nicht
Die Serverantwort zeigt, was technisch erreichbar ist. Das Logfile zeigt, ob ein Bot tatsächlich angefragt hat und welchen Statuscode er bekam. Das ist besonders wertvoll, wenn ein Crawler mitten im Lauf mit 403, 429, 5xx oder einer Redirect-Kette hängen bleibt:
Select-String -Path .\access.log -Pattern 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Googlebot'

Select-String -Path .\access.log -Pattern ' 403 | 404 | 429 | 5[0-9][0-9] '
Ein User-Agent allein beweist allerdings keine Identität; den kann jeder nachbauen. Für eine belastbare Auswertung gehören die veröffentlichten IP-Bereiche beziehungsweise die vom Anbieter beschriebene Bot-Verifikation dazu. Auch die Namen stehen nicht für denselben Zweck: OpenAI trennt OAI-SearchBot für die Suche, GPTBot für mögliches Training und ChatGPT-User für nutzerinitiierte Abrufe. Anthropic unterscheidet ClaudeBot, Claude-SearchBot und Claude-User. Perplexity dokumentiert PerplexityBot für Suchergebnisse und Perplexity-User für Abrufe auf Nutzerwunsch.
Was ein Logfile nicht beweist: dass Ihre Seite in einer Antwort zitiert, korrekt verstanden oder bevorzugt wurde. Dafür brauchen Sie einen dokumentierten Fund, wiederholbare Abfragen und im besten Fall messbare Verweise. Genau diese Trennung ist wichtig. Ein Bot-Besuch ist ein technischer Kontakt, noch kein GEO-Erfolg.
Drei Rebuilds, ein Quelltext-Prinzip
Bei New Advertising, Fix & Flott und Daniel Hacker habe ich den wichtigen Inhalt bewusst in HTML gelegt. JavaScript übernimmt progressive Verbesserungen: Navigation, Punktmuster, Animationen, Filter und Komfortfunktionen. Fällt JavaScript aus, bleibt die Seite nicht leer.
Das war nicht nur eine GEO-Entscheidung. Nach dem WordPress-Hack waren Sicherheit, Wartbarkeit und Performance die Auslöser. Dass der Inhalt heute auch ohne JavaScript vollständig lesbar bleibt, ist ein willkommener Nebeneffekt. Meine technischen PageSpeed-Werte belegen Performance- und Qualitätsarbeit, aber keine automatische Platzierung in einer KI-Antwort. Auch das muss man sauber auseinanderhalten.
Statisches HTML ist kein Zitier-Trick
Ein Baukasten oder CMS kann serverseitig gerendertes HTML ausliefern und damit hervorragend funktionieren. Eine individuell programmierte Seite kann umgekehrt technisch fast leer bleiben, wenn sie Inhalte erst clientseitig nachlädt, Bots aussperrt oder fachlich nichts Eigenes sagt. Der entscheidende Vergleich lautet deshalb nicht Baukasten gegen Handarbeit, sondern vollständige Serverantwort gegen leere Anwendungshülle.
Meine Beobachtung ist ein Einzelfall, kein kontrollierter Vergleich. Ich habe drei Seiten umgebaut, mehrere technische Probleme gleichzeitig gelöst und noch keinen belastbaren A/B-Test mit identischem Inhalt durchgeführt. Das Ergebnis darf deshalb nicht lauten: „HTML gewinnt gegen WordPress.“ Die sauberere Aussage lautet: Der wichtige Inhalt muss in der ersten Serverantwort oder in einer verlässlich gerenderten Variante verfügbar sein. Ob das mit statischem HTML, SSR, Pre-Rendering oder einem gut konfigurierten CMS passiert, ist die Architekturfrage danach.
Reparieren oder neu bauen?
| Ausgangslage | Sinnvoller Schritt | Warum |
|---|---|---|
| Inhalt steht bereits im HTML | Nichts Grundsätzliches ändern | JS kann als progressive Verbesserung bleiben. Crawl- und Accessibility-Tests ergänzen. |
| Einzelne wichtige Blöcke werden nachgeladen | Serverseitig ausgeben oder HTML-Fallback ergänzen | Meist kleiner, sicherer Eingriff als ein kompletter Rebuild. |
| Leerer App-Container, kein Fallback | SSR, Pre-Rendering oder statische Ausgabe prüfen | Der Crawler bekommt sonst nur Gerüst und Skriptverweise. |
| Sicherheits- und Wartungsproblem wie bei mir | Rebuild ernsthaft kalkulieren | Nicht aus Angst vor KI, sondern wegen Risiko, Pflegeaufwand und tatsächlicher Projektanforderung. |
Was davon in einem Jahr noch gilt
Die konkreten Bot-Namen, Crawl-Raten und Render-Fähigkeiten werden sich verändern. Anbieter können neue Such-Crawler starten, ihre User-Agents trennen oder Rendering ergänzen. Deshalb gehört zu jeder GEO-Aussage ein Forschungsdatum. Dieser Beitrag beruht auf dem Stand ; die Vercel-Zahlen und Rendering-Beobachtungen stammen aus der dort veröffentlichten Untersuchung vom Dezember 2024.
Der robustere Grundsatz ist weniger spektakulär: Inhalte, die ohne Login, Klick und JavaScript im HTML verständlich sind, haben weniger technische Hürden. Dazu kommen Aktualität, Quellen, klare interne Verlinkung, strukturierte Daten, erreichbare URLs und ein Server, der nicht mitten im Crawl dichtmacht. Wer die Entwicklung verfolgen will, sollte nicht nur einen Score anschauen, sondern die eigenen Logs, Search Console, PageSpeed und die tatsächlichen Antworten der Bots regelmäßig prüfen.
Mein Fazit: Erst prüfen, dann umbauen
Statisches HTML ist kein Trick, mit dem man in KI-Antworten kommt. Es sorgt dafür, dass überhaupt etwas zu lesen da ist, wenn ein Crawler vorbeikommt, der kein JavaScript ausführt – und genau dieses Verhalten wurde 2024 bei mehreren großen spezialisierten KI-Crawlern gemessen. Alles Weitere entscheidet der Inhalt: eigene Erfahrungen und Daten, klare Aussagen, belastbare Quellen und nachvollziehbare Autorenschaft.
Deshalb meine konkrete Empfehlung, in dieser Reihenfolge: Erstens den Drei-Minuten-Test machen und nachsehen, ob Ihr wichtigster Satz im Quelltext steht. Zweitens, falls er fehlt, ihn dort hineinbringen – serverseitig gerendert oder statisch ausgeliefert, nicht zwingend durch Verzicht auf JavaScript. Drittens einmal im Quartal ins Logfile schauen, ob die Bots überhaupt durchkommen oder mit 403 und 429 abgewiesen werden. Und viertens: Bauen Sie nichts neu, nur weil ein Beitrag wie dieser Ihnen Angst macht. Ich verdiene mein Geld mit Neubauten; umso deutlicher sage ich, dass die meisten Seiten repariert und nicht ersetzt gehören.
Meine eigene Umstellung war kein Geniestreich, sondern die Folge eines Hacks. Dass sie sich heute technisch auszahlt, ist ein Nebeneffekt – überprüfbar am Quelltext, nicht an meinem Wort. Ob daraus mehr KI-Sichtbarkeit entsteht, messe ich getrennt und behaupte es erst, wenn ich dafür belastbare Daten habe.
Recherchestand: . Die Herstellerdokumentationen von OpenAI, Anthropic, Perplexity und Google wurden an diesem Tag geprüft. Die Crawler-Messwerte und Aussagen zum JavaScript-Rendering stammen aus der Vercel-/MERJ-Auswertung vom 17. Dezember 2024.
Quellen
- Vercel/MERJ: The Rise of the AI Crawler, 17. Dezember 2024
- Google Search Central: JavaScript-SEO-Grundlagen
- Google Search Central: KI-Funktionen und deine Website
- OpenAI: OAI-SearchBot, GPTBot und ChatGPT-User
- Anthropic: ClaudeBot, Claude-SearchBot und Claude-User
- Perplexity: PerplexityBot und Perplexity-User
- Mein Beitrag: Gehackt – warum ich WordPress durch statisches HTML ersetzt habe
- Mein Beitrag: SEO vs. GEO – wo sie zusammengehören
- Mein Beitrag: Welche KI ist die beste?